

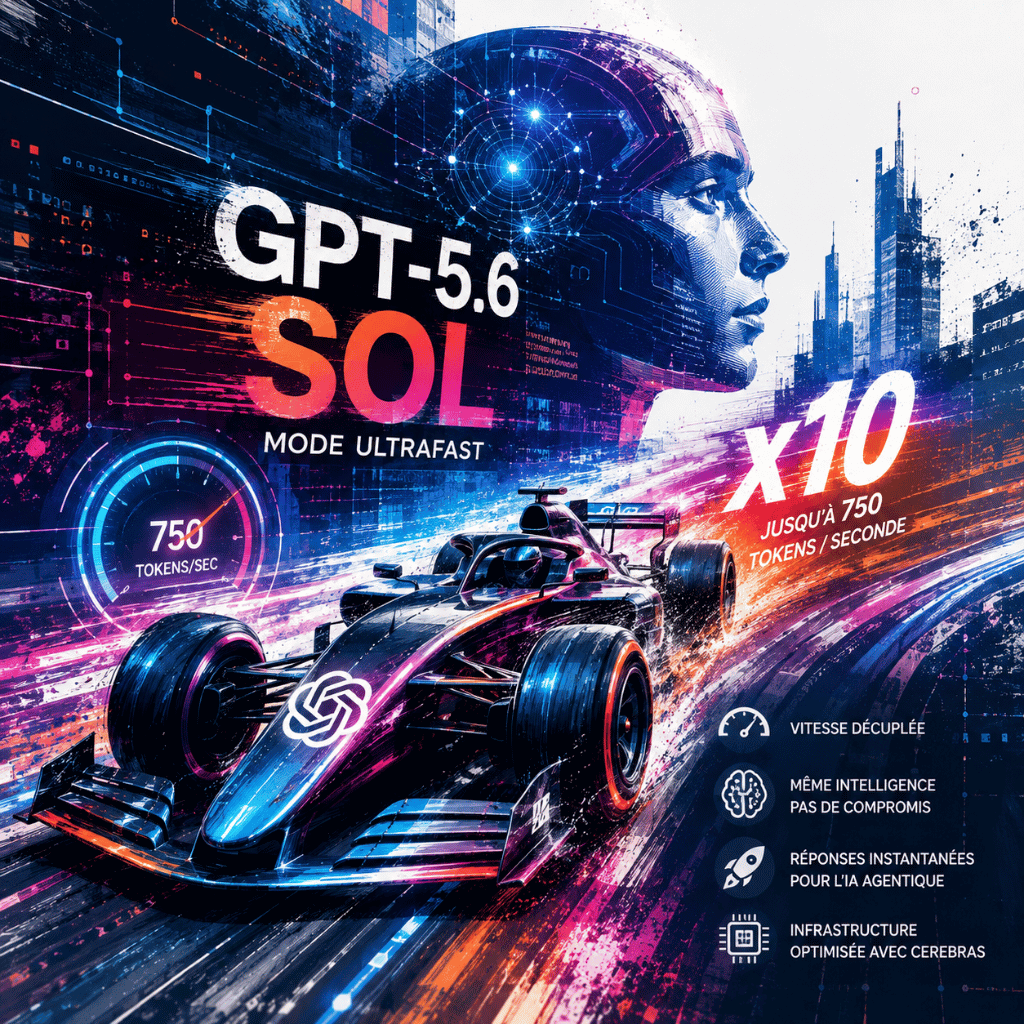
Quelques semaines après avoir généralisé GPT-5.6, OpenAI s’attaque à un autre défi majeur de l’intelligence artificielle : la latence. Avec son nouveau mode Ultrafast, l’entreprise veut permettre à son modèle phare GPT-5.6 Sol de produire ses réponses à une vitesse jusqu’ici surtout associée à des modèles beaucoup plus légers. Le débit annoncé peut atteindre 750 tokens par seconde, tout en conservant le même modèle et donc, selon OpenAI, sans sacrifier ses capacités de raisonnement.¹ Cette accélération pourrait sembler purement technique, mais elle touche en réalité un enjeu essentiel de l’IA agentique. Lorsqu’un agent doit analyser des informations, appeler plusieurs outils, vérifier un résultat puis poursuivre son travail, chaque seconde de latence se multiplie au fil des étapes. Avec Ultrafast, OpenAI veut précisément réduire cette attente et rapprocher les agents IA d’une véritable exécution en temps réel.
750 tokens par seconde : GPT-5.6 Sol change de rythme
GPT-5.6 Sol est le modèle le plus puissant de la famille GPT-5.6, devant Terra et Luna, avec un positionnement orienté vers les tâches complexes de programmation, de recherche, de cybersécurité, de science et d’automatisation. OpenAI avait déjà annoncé son exécution sur l’infrastructure de Cerebras à une vitesse pouvant atteindre 750 tokens par seconde, un niveau très supérieur à celui d’une inférence traditionnelle.¹ L’intérêt d’Ultrafast réside surtout dans le fait qu’OpenAI ne présente pas cette accélération comme une nouvelle déclinaison allégée du modèle. Le principe consiste à exécuter GPT-5.6 Sol sur une infrastructure spécialement optimisée pour l’inférence à très faible latence, afin de conserver son niveau d’intelligence tout en réduisant fortement le temps nécessaire à la génération.
La différence avec les modes d’accélération traditionnels est importante. Jusqu’ici, obtenir une réponse plus rapide impliquait souvent de choisir un modèle plus petit ou de réduire l’effort de raisonnement. Ultrafast cherche au contraire à dissocier davantage intelligence et vitesse, grâce à une optimisation de l’infrastructure qui exécute le modèle. En pratique, atteindre 750 tokens par seconde signifie que de longues réponses peuvent apparaître presque instantanément une fois la génération commencée. Le résultat réel dépend toutefois de nombreux paramètres, notamment du temps de raisonnement initial, de la longueur du contexte, des appels à des outils externes et de la charge de l’infrastructure. OpenAI précise d’ailleurs que les performances réelles peuvent varier selon les workloads.¹
Cerebras, le moteur caché derrière cette accélération
Pour atteindre de telles performances, OpenAI s’appuie sur Cerebras Systems, une entreprise américaine spécialisée dans les processeurs conçus pour l’intelligence artificielle. Son approche diffère de celle des infrastructures GPU traditionnelles : Cerebras développe des processeurs à l’échelle d’une tranche entière de silicium, les Wafer-Scale Engines, afin de rapprocher davantage la mémoire et les unités de calcul et de réduire les transferts de données qui ralentissent l’inférence.²
Cette collaboration dépasse largement le lancement d’un simple mode rapide. OpenAI et Cerebras ont conclu en 2026 un accord pluriannuel portant sur le déploiement de 750 MW de capacité d’inférence, avec une montée en puissance progressive de l’infrastructure jusqu’en 2028.² Le montant exact associé au partenariat a évolué au fil des annonces et documents financiers, mais il se chiffre en dizaines de milliards de dollars, ce qui montre l’importance stratégique accordée par OpenAI à l’inférence rapide.³ Derrière Ultrafast se dessine donc une évolution plus profonde du marché : après plusieurs années consacrées à entraîner des modèles toujours plus puissants, les laboratoires cherchent désormais à optimiser la manière dont ces modèles fonctionnent une fois déployés.
Les agents IA pourraient être les premiers grands gagnants
Pour une conversation classique avec ChatGPT, gagner quelques secondes apporte essentiellement davantage de confort. Pour une IA agentique, l’impact peut être beaucoup plus important. Un agent autonome ne génère pas nécessairement une seule réponse. Il peut rechercher une information, analyser un fichier, interroger une base de données, exécuter du code, vérifier le résultat obtenu puis recommencer jusqu’à atteindre son objectif. Chaque étape mobilise le modèle et ajoute de la latence au workflow global.
Avec une inférence beaucoup plus rapide, ces chaînes d’actions peuvent devenir nettement plus fluides. Un développeur pourrait confier à un agent l’analyse de logs et la recherche d’une erreur pendant qu’un autre prépare une correction. Un analyste financier pourrait exploiter plusieurs sources simultanément avant d’obtenir une synthèse. Dans le support client ou les interfaces vocales, la diminution de la latence pourrait rendre les échanges avec une intelligence artificielle beaucoup plus naturels. OpenAI positionne déjà GPT-5.6 Sol comme un modèle particulièrement performant pour les tâches agentiques et le développement logiciel, notamment grâce à ses résultats sur Terminal-Bench, les évaluations de coding agents et les workflows professionnels de longue durée.⁴
La vitesse ne supprime cependant pas tous les goulots d’étranglement. Un agent reste dépendant du temps nécessaire pour accéder à une API, charger un document, effectuer une recherche ou obtenir une validation humaine. Ultrafast accélère le moteur de raisonnement, mais il ne rend pas instantanément l’ensemble du système informatique qui l’entoure. C’est pourquoi les gains seront probablement les plus visibles dans les applications où l’inférence constitue actuellement une part importante du temps total d’exécution.


Executive MBA AI & Business
Transformation
Le MBA repensé pour l’ère de l’IA. Pour dirigeants expérimentés qui veulent piloter la transformation de leur organisation. Paris, Nice & Dubai.
Un mode très rapide, mais encore loin d’être accessible à tous
C’est ici que la promesse d’Ultrafast rencontre sa principale limite. Une infrastructure capable d’exécuter un modèle de frontière à plusieurs centaines de tokens par seconde nécessite des capacités matérielles considérables. OpenAI avait dès le lancement de GPT-5.6 indiqué que l’accès à l’exécution de Sol sur Cerebras serait initialement limité à certains clients, le temps d’augmenter progressivement les capacités disponibles.¹
Cette situation crée un contraste avec la stratégie plus large d’OpenAI autour de GPT-5.6. La famille est désormais disponible beaucoup plus largement, avec Sol comme modèle phare, Terra pour équilibrer performances et coût, et Luna comme option plus rapide et économique. GPT-5.6 Sol est facturé dans l’API 5 dollars par million de tokens en entrée et 30 dollars en sortie, tandis que Terra coûte respectivement 2,50 et 15 dollars et Luna 1 et 6 dollars.⁴ L’accès à certaines capacités avancées dépend également de l’offre ChatGPT ou Codex utilisée. OpenAI déploie par exemple GPT-5.6 Sol progressivement sur les forfaits éligibles, tandis que les options de raisonnement les plus avancées sont réservées à certains abonnements.⁵
Pour Ultrafast, le véritable enjeu sera donc autant économique que technologique. Si le coût de cette accélération est élevé, elle sera surtout pertinente pour les applications où chaque seconde possède une valeur directe : assistance en temps réel, développement logiciel interactif, réponse à incident, agents conversationnels, transactions ou analyse opérationnelle. Pour les traitements exécutés en arrière-plan, comme l’indexation de documents ou les analyses nocturnes, un mode standard moins coûteux pourrait rester beaucoup plus rationnel.
OpenAI prépare une nouvelle bataille autour de l’inférence
Le partenariat avec Cerebras révèle aussi une transformation de la compétition entre les acteurs de l’intelligence artificielle. Jusqu’à présent, la course était principalement évaluée à travers la taille des modèles, leurs benchmarks ou leur capacité à raisonner. Désormais, le temps nécessaire pour obtenir cette intelligence devient lui-même un avantage concurrentiel.
Pour OpenAI, travailler avec Cerebras permet également de diversifier son infrastructure de calcul dans un marché historiquement dominé par les GPU Nvidia. Cerebras affirme que ses architectures spécialisées permettent de réduire certains goulets d’étranglement liés aux déplacements de données et d’obtenir des débits particulièrement élevés pour l’inférence.² OpenAI ne remplace pas pour autant son infrastructure existante, mais ajoute une nouvelle catégorie de ressources optimisées pour les workloads où la latence est critique.
Cette évolution pourrait progressivement modifier la manière dont les entreprises choisissent leurs modèles. La meilleure IA ne sera plus nécessairement celle qui obtient le meilleur score absolu sur un benchmark, mais celle qui offre le meilleur compromis entre qualité, coût, consommation de tokens et temps d’exécution.
Les enjeux éthiques : quand la vitesse réduit aussi le temps de contrôle
Rendre une intelligence artificielle dix fois plus rapide n’est pas uniquement un progrès technique. Plus les agents peuvent analyser, décider et agir rapidement, plus la question du contrôle humain devient importante. Dans un système agentique classique, la latence laisse encore du temps pour vérifier une action, interrompre un processus ou demander une validation. Lorsque plusieurs agents peuvent enchaîner des décisions en quelques secondes, cette fenêtre d’intervention peut se réduire considérablement.
L’enjeu devient particulièrement sensible dans la cybersécurité, la finance, les infrastructures critiques ou les processus administratifs automatisés. GPT-5.6 Sol possède déjà des capacités avancées en cybersécurité et OpenAI reconnaît que les évaluations ne peuvent pas couvrir toutes les combinaisons possibles entre modèles, outils et workflows. L’entreprise affirme avoir renforcé ses mécanismes de sécurité avec des contrôles en temps réel, du monitoring, du red teaming humain et automatisé ainsi qu’un accès adapté au niveau de risque.¹
Un deuxième enjeu concerne l’inégalité d’accès à la puissance de calcul. Si les versions les plus rapides des meilleurs modèles restent accessibles uniquement aux grandes entreprises capables de payer une infrastructure premium, un écart pourrait se creuser entre les organisations disposant d’agents presque instantanés et celles utilisant des systèmes plus lents. La vitesse deviendrait alors un avantage économique à part entière, au même titre que l’accès aux modèles les plus performants.
Enfin, cette accélération pose une question environnementale. Les infrastructures nécessaires pour servir des modèles de frontière à très haute vitesse mobilisent des capacités électriques considérables. L’accord portant sur 750 MW entre OpenAI et Cerebras illustre l’échelle industrielle désormais nécessaire pour faire fonctionner les systèmes d’IA modernes.² La course à la latence devra donc être évaluée non seulement en tokens par seconde, mais aussi en efficacité énergétique et en valeur réellement produite par chaque calcul.
Après l’intelligence, la course à la vitesse est lancée
Avec Ultrafast, OpenAI montre que la prochaine frontière de l’intelligence artificielle ne consiste plus uniquement à rendre les modèles plus intelligents. Elle consiste également à rendre cette intelligence suffisamment rapide pour intervenir au rythme des activités humaines et des systèmes informatiques. GPT-5.6 Sol peut déjà raisonner, coder, utiliser des outils et coordonner des workflows complexes. En atteignant jusqu’à 750 tokens par seconde sur l’infrastructure Cerebras, ces capacités peuvent désormais être mobilisées avec une latence considérablement réduite.¹
Cette évolution pourrait être particulièrement déterminante pour les agents IA, dont l’efficacité dépend autant de leur capacité de raisonnement que du temps nécessaire pour accomplir chaque étape. Mais Ultrafast met également en évidence les nouvelles tensions de l’industrie : coûts d’infrastructure, accès inégal aux capacités premium, consommation énergétique et nécessité de maintenir un contrôle humain lorsque les systèmes automatisés agissent toujours plus vite. La prochaine compétition entre OpenAI, Anthropic, Google et les autres laboratoires ne portera donc peut-être plus uniquement sur la question « quelle IA est la plus intelligente ? », mais aussi sur une autre, de plus en plus décisive : combien de temps faut-il attendre pour qu’elle agisse ?
Comment fonctionne le mode Ultrafast de GPT-5.6 Sol ?
Le mode Ultrafast est une nouvelle option d’exécution développée par OpenAI pour GPT-5.6 Sol, avec l’objectif de réduire fortement la latence sans remplacer le modèle par une version plus légère. Contrairement aux approches qui privilégient la vitesse en diminuant les capacités de raisonnement, Ultrafast conserve GPT-5.6 Sol tout en optimisant l’infrastructure utilisée pour son inférence. Le système peut ainsi atteindre jusqu’à 750 tokens générés par seconde, ce qui permet d’accélérer considérablement la production de réponses longues et l’exécution de tâches nécessitant plusieurs interactions successives avec le modèle.
Cette accélération repose notamment sur l’infrastructure de Cerebras Systems, spécialisée dans les processeurs dédiés à l’intelligence artificielle. Son architecture Wafer-Scale Engine utilise une très grande surface de silicium associée à une mémoire placée au plus près des unités de calcul. Cette conception vise à limiter les transferts permanents de données entre le processeur et une mémoire externe, qui constituent l’un des principaux facteurs de ralentissement lors de l’inférence des grands modèles de langage.
Ultrafast prend une importance particulière dans le domaine de l’IA agentique. Un agent ne produit pas nécessairement une réponse unique, il peut analyser une demande, consulter plusieurs outils, exécuter du code, examiner un résultat, corriger une erreur puis poursuivre son travail. Chaque étape nécessite potentiellement un nouvel appel au modèle. En accélérant GPT-5.6 Sol, OpenAI cherche donc à réduire la durée de ces boucles successives et à rapprocher certains workflows agentiques d’une exécution en temps réel.
Cette approche pourrait être particulièrement intéressante pour le développement logiciel, l’analyse de données, le support conversationnel, la recherche financière ou encore la réponse à incident. La vitesse du modèle ne supprime cependant pas les autres sources de latence. Les appels à des API externes, l’accès aux bases de données, le chargement de documents et les validations humaines peuvent toujours ralentir le workflow global. Ultrafast accélère donc principalement la partie du processus directement liée à l’inférence de GPT-5.6 Sol.
- Inférence à très haute vitesse : génération pouvant atteindre jusqu’à 750 tokens par seconde selon les conditions d’utilisation
- GPT-5.6 Sol conservé : accélération du modèle phare sans recours annoncé à une déclinaison plus légère
- Infrastructure Cerebras : utilisation d’une architecture matérielle spécialisée pour réduire les déplacements de données et la latence
- Optimisation des agents IA : accélération des boucles de raisonnement, d’utilisation d’outils, de vérification et d’exécution
- Développement logiciel : possibilité de rendre plus interactifs les workflows de génération, d’analyse et de correction de code
- Applications en temps réel : intérêt pour les assistants vocaux, le support client, l’analyse opérationnelle ou la réponse à incident
- Intégration API : mode destiné aux usages professionnels et aux applications exploitant GPT-5.6 Sol via l’écosystème OpenAI
- Ultrafast reste dépendant de capacités de calcul spécialisées et importantes, ce qui peut limiter son déploiement à grande échelle
- L’accès reste restreint et son ouverture dépend de la disponibilité des capacités d’infrastructure
- Le débit maximal annoncé ne correspond pas nécessairement à la vitesse obtenue dans toutes les situations
- Les appels aux outils, API, bases de données ou systèmes externes peuvent continuer à ralentir les workflows agentiques
- Une augmentation de la vitesse d’exécution ne garantit pas automatiquement une amélioration de la précision ou de la fiabilité des réponses
- Les systèmes agissant plus rapidement nécessitent des mécanismes de supervision adaptés, notamment lorsque les agents peuvent effectuer plusieurs actions autonomes successives
- Le coût et la disponibilité de l’infrastructure à grande échelle constituent des facteurs déterminants pour l’adoption du mode dans les entreprises
Learn more
Avec son mode Ultrafast, GPT-5.6 Sol illustre la recherche d’un nouvel équilibre entre puissance de raisonnement, vitesse d’exécution et fluidité d’usage des modèles d’intelligence artificielle. Sur un sujet directement lié, découvrez notre article « OpenAI lance GPT-5.5 Instant avec une réduction des erreurs et des réponses plus rapides », qui analyse l’étape précédente de cette évolution vers des modèles capables de répondre plus rapidement tout en améliorant la fiabilité de leurs résultats.
References
1. OpenAI. (2026). Previewing GPT-5.6 Sol: A Next-Generation Model.
https://openai.com/index/previewing-gpt-5-6-sol/
2. Cerebras Systems. (2026). OpenAI Partners with Cerebras to Bring High-Speed Inference to the Mainstream.
https://www.cerebras.ai/blog/openai-partners-with-cerebras-to-bring-high-speed-inference-to-the-mainstream
3. Reuters. (2026). OpenAI Signs $10 Billion Computing Deal with Nvidia Challenger Cerebras.
https://www.reuters.com/
4. OpenAI. (2026). GPT-5.6: Frontier Intelligence That Scales with Your Ambition.
https://openai.com/index/gpt-5-6/
5. OpenAI Help Center. (2026). GPT-5.6 in ChatGPT.
https://help.openai.com/en/articles/20001354-gpt-56-in-chatgpt/