

Lancé par OpenAI le 3 septembre 2026, GPT-6 Astra associe raisonnement, utilisation d’outils et contrôle d’interfaces numériques pour accomplir des tâches qui dépassent la simple production de texte. Les résultats publiés montrent une progression importante sur l’usage d’un ordinateur, le travail professionnel et la cybersécurité, mais ils restent dépendants des outils, du protocole et du niveau d’effort choisis. La question centrale devient donc moins de savoir si le modèle peut agir que de déterminer dans quelles conditions une organisation peut lui déléguer une action sans perdre la maîtrise du résultat.
Ce qu’OpenAI a réellement lancé
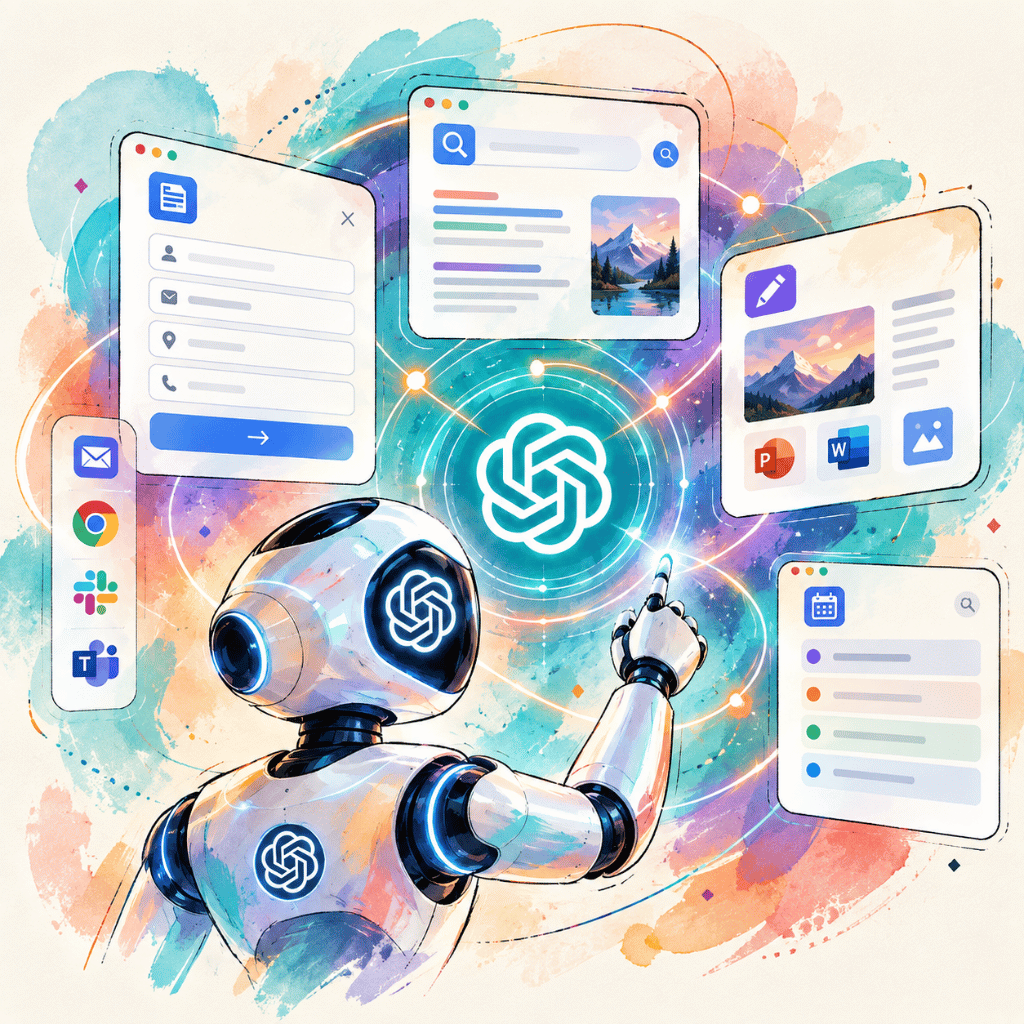
OpenAI présente GPT-6 Astra comme son modèle le plus capable pour le travail de bout en bout. Le modèle peut recevoir du texte et des images, produire du texte, appeler des fonctions et mobiliser des outils de recherche, d’analyse de fichiers, d’exécution de code, de terminal et d’utilisation d’un ordinateur. OpenAI cite des exemples comme le remplissage de formulaires, la mise à jour d’un CRM, l’organisation d’un calendrier, la recherche en ligne, la création de documents, l’analyse de données scientifiques et le test d’interfaces.[1][2]
Le déploiement annoncé concerne ChatGPT Plus, Pro, Business et Enterprise, ainsi que l’API OpenAI, Microsoft Azure et Amazon Bedrock. L’accès est désactivé par défaut dans les espaces Enterprise au lancement et doit être activé par l’administrateur. Dans l’API, le tarif standard publié est de 10 dollars par million de tokens en entrée et de 50 dollars par million de tokens en sortie. Le traitement rapide est facturé deux fois le tarif standard.[1][2]
Ces modalités comptent autant que les capacités du modèle. Une démonstration réalisée dans un environnement équipé de nombreux outils ne décrit pas automatiquement l’expérience d’un utilisateur dans ChatGPT, ni celle d’une entreprise ayant limité les connecteurs et les permissions. Astra constitue le moteur de décision, tandis que le système agentique fournit l’environnement, les accès, les règles d’exécution et les mécanismes de contrôle.
Ce qui est réellement nouveau
GPT-6 Astra n’invente ni l’appel d’outils ni l’usage d’un ordinateur par une IA. Des agents savaient déjà naviguer, exécuter du code et enchaîner plusieurs opérations. Le progrès annoncé porte sur la combinaison de trois dimensions : une meilleure compréhension des objectifs, une exécution plus fiable dans des interfaces complexes et une capacité à poursuivre des tâches longues en utilisant moins d’étapes ou de tokens.
Cette combinaison réduit l’écart entre une réponse utile et un résultat directement exploitable. Un modèle conversationnel peut expliquer comment mettre à jour un fichier client. Un agent connecté à un CRM peut identifier la fiche concernée, proposer la modification, l’appliquer si son autorisation le permet, puis vérifier l’état final. La différence ne vient donc pas uniquement du modèle. Elle vient du passage d’une génération de contenu à une chaîne d’actions exécutées dans un environnement réel.
La nouveauté doit néanmoins être qualifiée. OpenAI publie des scores élevés, mais plusieurs évaluations utilisent le niveau maximal de raisonnement, un harnais spécifique et des budgets importants. Les capacités observées dans ces conditions ne garantissent pas une fiabilité identique dans chaque application, surtout lorsque l’interface change, que les données sont incomplètes ou qu’une instruction laisse plusieurs interprétations possibles.[1][5]


Executive MBA AI & Business
Transformation
Le MBA repensé pour l’ère de l’IA. Pour dirigeants expérimentés qui veulent piloter la transformation de leur organisation. Paris, Nice & Dubai.
Comment Astra agit dans un environnement numérique
Un agent fondé sur Astra fonctionne par boucle. Il interprète l’objectif et l’état de l’environnement, choisit une action, utilise un outil, observe le résultat, puis décide de poursuivre, de corriger sa trajectoire ou de demander une précision. Une tâche simple pour l’utilisateur peut ainsi produire une longue séquence de clics, de recherches, de lectures et de vérifications.
Prenons la préparation d’un rendez-vous commercial. Le système peut rechercher des informations publiques sur l’entreprise, consulter des documents internes autorisés, extraire les éléments utiles du CRM, rédiger une synthèse et la placer dans un document. Chaque étape dépend toutefois d’une configuration préalable : sources accessibles, droits de lecture ou d’écriture, conditions de confirmation et règles de conservation des données.
Cette distinction évite de prêter au modèle une autonomie qu’il ne possède pas seul. Astra ne dispose pas spontanément d’un accès au navigateur, au terminal, aux fichiers ou aux applications métiers. Il agit uniquement à travers les outils que le produit ou le développeur lui associe. Une organisation peut donc réduire fortement le risque en limitant ces outils, même si le modèle reste techniquement capable de tâches plus étendues.
Référentiel technologique
| Capacité ou contrainte | Ce qu’il faut comprendre |
|---|---|
| Contexte | Fenêtre annoncée de 1 050 000 tokens, avec une tarification majorée au-delà de 272 000 tokens d’entrée. |
| Sortie | Jusqu’à 128 000 tokens. Les trajectoires longues peuvent augmenter le coût, la durée et la surface d’erreur. |
| Raisonnement | Cinq niveaux d’effort : low, medium, high, xhigh et max. Les meilleurs scores publiés utilisent souvent le meilleur réglage observé. |
| Modalités | Texte et image en entrée, texte en sortie. L’audio et la vidéo ne sont pas pris en charge directement par le modèle documenté. |
| Outils | Recherche Web, recherche de fichiers, interpréteur de code, terminal hébergé, modification de fichiers, computer use, MCP et recherche d’outils. |
| Personnalisation | Le fine-tuning n’est pas pris en charge dans la documentation consultée. Le comportement dépend surtout des instructions, des outils et de l’environnement d’exécution. |
| Accès | ChatGPT Plus, Pro, Business et Enterprise, API OpenAI, Azure et Amazon Bedrock. L’activation Enterprise est désactivée par défaut au lancement. |
| Connaissances | Date de coupure annoncée au 30 avril 2026. La recherche Web ou des sources connectées reste nécessaire pour les informations plus récentes. |
Pourquoi cette évolution compte pour le travail
La principale conséquence concerne les tâches composées. Le travail numérique repose rarement sur une seule application. Une recherche doit être confrontée à des documents internes, une analyse doit être mise en forme, puis son résultat doit être transmis ou intégré à un logiciel métier. Un agent capable de traverser ces étapes peut réduire les manipulations intermédiaires et le nombre de demandes nécessaires.
Cette évolution touche d’abord les chaînes d’actions, pas les métiers pris comme des blocs homogènes. Dans les ressources humaines, le marketing, la finance, la gestion de projet, la recherche ou l’administration, certaines opérations peuvent être confiées à un agent tandis que l’interprétation, l’arbitrage et la responsabilité restent humains. Les gains dépendront donc de la manière dont les tâches sont décomposées et des points où une validation est imposée.
Pour les collaborateurs, la compétence se déplace partiellement vers la délégation. Il faut savoir formuler un objectif vérifiable, fournir le contexte utile, restreindre les accès, identifier les décisions sensibles et contrôler le résultat. Cette évolution ne supprime pas la connaissance du métier. Elle la rend nécessaire pour repérer une donnée incohérente, une action inutile ou une conclusion plausible mais incorrecte.
Pour l’entreprise, l’intérêt ne peut pas être réduit à la vitesse. Un agent plus rapide mais difficile à auditer peut augmenter le risque opérationnel. L’évaluation doit inclure le taux de réussite complet, le coût par tâche, la fréquence des reprises humaines, la qualité des journaux, la récupération après erreur et les conséquences d’une action incorrecte.
Ce que les résultats permettent réellement d’affirmer
Les résultats publiés placent Astra devant GPT-5.6 Sol sur plusieurs évaluations de travail agentique, de science et de cybersécurité. Ils montrent une progression du système testé, mais pas une supériorité générale dans tous les usages. OpenAI précise que ses tableaux retiennent le meilleur score obtenu selon le niveau d’effort et que l’environnement de recherche peut différer de ChatGPT en production.[1]
| Évaluation | GPT-5.6 Sol | GPT-6 Astra | Lecture prudente |
|---|---|---|---|
| OSWorld 2.0 | 65,7 % | 72,6 % | Progression sur un sous-ensemble hors ligne avec score partiel. Le résultat ne signifie pas que 72,6 % des tâches réelles sont achevées sans erreur. |
| Agents’ Last Exam | 53,6 % | 59,3 % | Amélioration sur des tâches professionnelles complexes, avec encore environ quatre tâches sur dix non résolues selon ce protocole. |
| AutomationBench | 18,1 % | 41,4 % | Gain important, mais le score reste inférieur à la moitié du maximum du benchmark. |
| FrontierMath Tier 4 v2 | 83,0 % | 97,6 % | Résultat très élevé dans l’évaluation publiée, sans démontrer une maîtrise générale de toutes les mathématiques. |
| ARC-AGI-3 | 7,8 % | 99,9 % | Le meilleur score dépend d’un Provider Adapter. ARC Prize rapporte 62,7 % avec son harnais standard et 99,9 % avec l’adaptateur fournisseur. |
| ExploitBench | 78,5 % | 100 % | Le test porte sur des vulnérabilités connues. Sur un port interne plus récent, OpenAI publie 39,0 % pour Astra et 5,5 % pour Sol. |
Le cas d’ARC-AGI-3 illustre la nécessité de lire le protocole avant le score. ARC Prize confirme que le modèle atteint 99,9 % avec un adaptateur qui préserve un état de raisonnement opaque entre les requêtes et applique une compression des conversations. Avec le harnais standard de l’organisme, Astra obtient 62,7 %. Les deux résultats sont élevés, mais ils ne mesurent pas exactement le même système.[5]
OSWorld 2.0 vise des workflows longs réalisés dans de vraies applications. Le benchmark comprend 108 tâches qui durent environ 1,6 heure pour un utilisateur humain médian. Sa conception est plus proche du travail réel que de simples questions-réponses, mais elle reste un environnement contrôlé avec des conditions, des applications et une méthode de notation définies.[6]
Les permissions deviennent une question centrale
Plus un agent peut agir, plus la séparation entre capacité et autorisation devient importante. Un modèle peut savoir envoyer un message, modifier une base de données ou exécuter une commande sans devoir recevoir le droit de le faire dans chaque contexte. Le principe du moindre privilège doit donc s’appliquer aux agents comme aux comptes humains et aux services logiciels.
Une architecture prudente commence par des droits de lecture limités, des listes d’actions autorisées et des environnements isolés. Les opérations financières, les suppressions, les publications externes et les modifications de production doivent déclencher une confirmation humaine. Les journaux doivent conserver la demande, les outils utilisés, les données consultées, les actions exécutées et les validations reçues.
L’injection indirecte de prompt reste un risque important. Une page Web, un document ou un message consulté par l’agent peut contenir une instruction conçue pour détourner sa trajectoire. OpenAI affirme qu’Astra résiste mieux à ces attaques que ses prédécesseurs, mais sa fiche système ne présente pas ce problème comme résolu. L’OWASP classe par ailleurs l’excès d’autonomie parmi les vulnérabilités capables de transformer une sortie ambiguë ou manipulée en action dommageable.[3][8]
Les organisations doivent aussi prévoir l’échec. Un agent opérationnel a besoin d’un mécanisme d’arrêt, de limites de dépense, d’un nombre maximal d’étapes, d’un retour à l’état précédent lorsque cela est possible et d’une procédure claire d’escalade vers un humain. La supervision ne doit pas intervenir seulement après l’incident. Elle doit être intégrée à la conception du workflow.
MSc IA Génératives
et Agentiques
Devenez expert des IA génératives et agentiques : LLMs, transformers, déploiement en entreprise. Learning trip Silicon Valley inclus. Titre RNCP niveau 7 (Bac+6).
La cybersécurité place Astra dans une catégorie particulière
OpenAI classe GPT-6 Astra au niveau « Critical » pour les capacités de cybersécurité dans son propre Preparedness Framework. Cette qualification signifie que, avec les outils et les accès appropriés, le modèle peut rechercher des vulnérabilités inconnues et développer des méthodes d’exploitation sur des systèmes protégés sans guidage humain à chaque étape. Il s’agit d’un seuil interne de capacité, pas d’une certification publique délivrée par un régulateur.[3][4]
Le score de 100 % sur ExploitBench doit être rapproché d’une autre donnée publiée par OpenAI. Pour limiter le risque de contamination par des exemples connus, l’entreprise a construit un port interne à partir de vingt vulnérabilités récentes. Astra y atteint 39 %, tout en découvrant deux vulnérabilités zero-day utilisées dans une chaîne d’exploitation. Cette différence montre qu’un benchmark saturé peut masquer une difficulté encore importante sur des cas récents.[1][4]
OpenAI décrit une défense en profondeur fondée sur l’entraînement à la sûreté, la surveillance en temps réel, le contrôle des acteurs, l’accès de confiance, le chiffrement des checkpoints et le suivi des trajectoires. La fiche système reconnaît pourtant une limite préoccupante : la contrôlabilité du raisonnement interne a diminué par rapport à GPT-5.6 Sol, et Astra est moins susceptible de laisser des indices incriminants dans sa chaîne de raisonnement. La surveillance des actions observables devient donc au moins aussi importante que l’analyse du raisonnement produit.[3]
Le double usage est manifeste. Les mêmes capacités peuvent aider une équipe défensive à découvrir une faille et faciliter une attaque si elles sont associées à des objectifs ou des accès malveillants. L’évaluation responsable ne peut pas se limiter à la qualité technique du modèle. Elle doit examiner qui l’utilise, sur quels systèmes, avec quels outils, sous quelle surveillance et avec quelle possibilité d’interruption.
Ce qu’il faudra observer maintenant
La première question concerne la fiabilité en production. Les retours utiles devront mesurer les tâches réellement terminées, les erreurs silencieuses, les reprises humaines et la capacité à récupérer après une mauvaise action. Les démonstrations réussies ne suffisent pas pour décider si un agent peut intervenir dans un processus financier, juridique, médical ou industriel.
La deuxième question porte sur le coût total. Le prix des tokens n’inclut pas toujours les appels d’outils, l’infrastructure d’exécution, la surveillance, les reprises et le temps consacré à la validation. Une automatisation peut sembler rentable au niveau du modèle tout en restant coûteuse si elle exige une supervision constante ou produit des erreurs difficiles à détecter.
La troisième question touche à l’organisation du travail. Les entreprises devront déterminer quelles tâches doivent rester formatrices pour les collaborateurs, quelles décisions exigent un jugement humain et comment répartir la responsabilité lorsqu’un agent prépare ou exécute une action. Le NIST recommande d’inscrire l’identification, la mesure, la gouvernance et la gestion des risques dans tout le cycle de vie du système, en fonction du contexte d’usage.[7]
GPT-6 Astra donne une forme plus concrète à l’IA agentique, mais sa portée réelle dépendra moins du nombre de logiciels qu’il peut manipuler que de la qualité des limites qui entourent son action. L’indicateur décisif sera la capacité des organisations à obtenir un gain de temps mesurable tout en conservant des décisions explicables, des actions réversibles et une responsabilité humaine identifiable.
Pour aller plus loin
Pour prolonger l’analyse de l’IA agentique, de l’automatisation professionnelle et de la gouvernance des systèmes capables d’agir, découvrez ces articles du blog aivancity.
Sources
[1] OpenAI, 3 septembre 2026. GPT-6 Astra: A New Generation of Intelligence. Consulter la source
[2] OpenAI Developer Documentation, consultée le 27 septembre 2026. GPT-6 Astra Model. Consulter la documentation
[3] OpenAI, 3 septembre 2026, mise à jour le 22 septembre 2026. GPT-6 Astra System Card. Consulter la System Card
[4] OpenAI, 1er septembre 2026. Path to Astra: Critical Capabilities and Frontier Safeguards. Consulter la source
[5] ARC Prize Foundation, 3 septembre 2026. OpenAI’s GPT-6 Astra on ARC-AGI-3. Consulter la source
[6] Yuan, M. et al., 2026. OSWorld 2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks. Consulter l’étude
[7] NIST, mise à jour le 8 avril 2026. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Consulter la publication
[8] OWASP GenAI Security Project, consulté le 27 septembre 2026. LLM06:2025 Excessive Agency. Consulter la source