

Par
Maître de conférences à aivancity
Directeur du MSc Intelligences Artificielles Génératives & Agentiques
Zainab Assaghir
Professeure des universités
Faculté des sciences, Université libanaise
Les bibliothèques de prompts éducatifs se multiplient, mais elles décrivent ce que l’on demande à l’IA générative de produire, rarement la fonction pédagogique de cette demande. Notre étude propose une taxonomie de cinq fonctions pédagogiques des prompts et montre qu’elle peut être appliquée de manière fiable par deux évaluateurs. Elle montre aussi qu’il est difficile de déduire, à partir du seul texte d’un prompt, le niveau de complexité cognitive qu’il mobilisera.
L’intelligence artificielle générative s’installe dans les pratiques éducatives, au point que l’UNESCO et l’OCDE lui consacrent désormais des cadres de recommandations (Miao et Holmes, 2023 ; OCDE, 2026). Les enseignants l’utilisent pour préparer des cours, concevoir des activités ou produire des supports ; les étudiants s’en servent pour obtenir des explications, s’entraîner ou recevoir des retours sur leur travail. Dans tous ces usages, l’interaction passe par un prompt, c’est-à-dire l’instruction rédigée pour un modèle d’IA générative.
Derrière cette diversité d’usages se pose une question plus fondamentale : que fait réellement un prompt sur le plan pédagogique ?
Demande-t-il simplement à l’IA de produire une réponse, guide-t-il progressivement l’apprenant, l’oblige-t-il à argumenter ou l’amène-t-il à évaluer son propre raisonnement ?
C’est à cette question que répond notre étude From Engineering to Pedagogy: A Functional Taxonomy for Teacher and Student-Facing Educational Prompting (De l’ingénierie à la pédagogie : une taxonomie fonctionnelle des prompts éducatifs destinés aux enseignants et aux étudiants), publiée dans les actes de la conférence EC-TEL 2026 (Yaacoub et Assaghir, 2027). Nous y proposons de classer les prompts éducatifs non pas uniquement selon la tâche qu’ils demandent d’accomplir, mais selon la fonction pédagogique qu’ils cherchent à remplir.
Après calibration, deux évaluateurs appliquant cette classification à 50 prompts inédits obtiennent un accord élevé (88 %, κ = 0,80). En revanche, le texte d’un prompt, pris isolément, ne permet pas de déduire de manière fiable le niveau de complexité cognitive qu’il mobilisera réellement. Les corpus, la grille de codage et le classeur d’annotation sont disponibles en accès ouvert sur la plateforme OSF.
Pourquoi regarder au-delà du « prompt engineering » ?
Les bibliothèques de prompts éducatifs se développent rapidement. Les revues de littérature récentes soulignent à la fois l’essor des grands modèles de langage en éducation, l’hétérogénéité des pratiques de rédaction des prompts et l’absence de cadre d’analyse partagé (Chen et al., 2024 ; Shi et al., 2026). Ces bibliothèques sont le plus souvent organisées autour de la tâche à réaliser : préparer une leçon, générer un quiz, créer une grille d’évaluation, expliquer une notion.
Cette organisation est utile en pratique, mais elle renseigne peu sur le mécanisme pédagogique recherché et rend difficile la comparaison des prompts d’un contexte à l’autre.
Deux prompts demandant apparemment la même tâche peuvent en effet organiser très différemment le travail cognitif.
L’un fournit directement une réponse ; un autre guide l’utilisateur étape par étape ; un troisième lui demande de justifier son raisonnement, d’envisager un contre-argument ou d’évaluer son propre travail.
La question n’est donc plus seulement de savoir ce que l’on demande à l’IA de produire, mais comment le prompt organise l’activité cognitive de l’enseignant ou de l’apprenant.
Cette distinction est importante en éducation, où la qualité d’une interaction avec une IA ne dépend pas seulement de la qualité de la réponse générée, mais aussi de ce que l’utilisateur est amené à faire lui-même.


Formation pour dirigeants
IA & Data Science
pour les Managers
Intégrez l’IA dans votre stratégie d’entreprise. Une approche 360° — Technologie, Business & Éthique — conçue pour les décideurs. Prérequis : 5 ans d’expérience managériale.
Cinq fonctions pédagogiques pour analyser les prompts
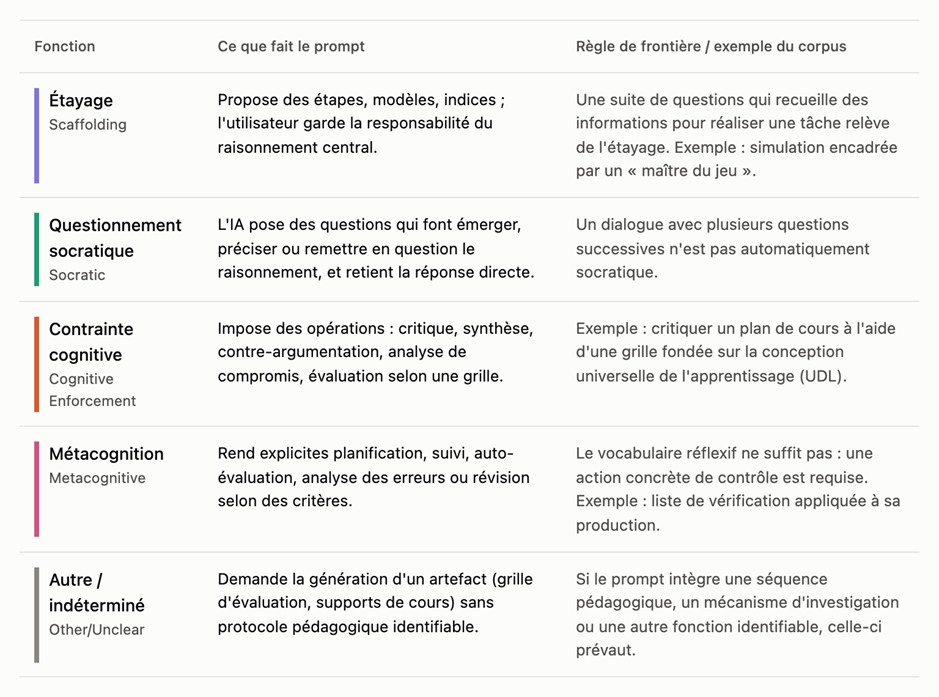
Notre taxonomie s’appuie sur la théorie de l’étayage (Wood, Bruner et Ross, 1976) et sur les travaux consacrés à l’apprentissage autorégulé (Zimmerman, 2002). Elle distingue cinq fonctions, et chaque prompt reçoit un seul code : celui de sa fonction dominante. Les noms anglais indiqués entre parenthèses sont ceux de la taxonomie publiée.
1. Étayage (Scaffolding) : guider sans raisonner à la place de l’apprenant
La catégorie Étayage regroupe les prompts qui proposent des étapes, des modèles, des indices ou des formes d’accompagnement progressif.
Le principe est d’apporter suffisamment de structure pour permettre à l’utilisateur d’avancer, tout en lui laissant la responsabilité du raisonnement central.
Un prompt de notre corpus demande par exemple à l’IA de construire une simulation pédagogique encadrée par un « maître du jeu », qui structure le déroulement de l’activité.
La frontière avec les autres catégories demande de la précision. Une succession de questions n’est pas automatiquement socratique : si les questions servent principalement à recueillir les informations nécessaires à la réalisation d’une tâche, elles relèvent de l’étayage. C’est l’une des règles de décision établies lors de la calibration.
2. Questionnement socratique (Socratic) : questionner plutôt que donner la réponse
Dans cette catégorie, l’IA est explicitement invitée à poser des questions qui font émerger, préciser ou remettre en question le raisonnement de l’utilisateur, et à retenir la réponse directe.
L’objectif n’est pas d’obtenir progressivement des informations, mais d’utiliser le questionnement pour faire travailler le raisonnement.
Cette définition évite de qualifier de « socratique » tout dialogue dans lequel l’IA pose plusieurs questions successives.
3. Contrainte cognitive (Cognitive Enforcement) : imposer des opérations qui obligent à approfondir
Cette catégorie désigne les prompts qui introduisent des contraintes obligeant l’utilisateur à mobiliser certaines opérations cognitives : critique, synthèse, contre-argumentation, analyse de compromis ou évaluation à partir d’une grille.
L’enjeu est de dépasser l’exécution superficielle d’une tâche.
Demander de produire un texte en plusieurs étapes ne suffit pas ; demander d’examiner un argument contradictoire, de comparer des options selon des critères explicites ou de critiquer un travail à partir d’une grille introduit une contrainte supplémentaire. Un prompt de notre corpus demande ainsi à l’IA de critiquer un plan de cours à l’aide d’une grille fondée sur la conception universelle de l’apprentissage (Universal Design for Learning).
4. Métacognition (Metacognitive) : observer son propre raisonnement
Cette fonction concerne les prompts qui rendent explicites des opérations de planification, de suivi, d’auto-évaluation, d’analyse des erreurs ou de révision selon des critères définis.
La présence d’un vocabulaire réflexif ne suffit pas : il faut qu’une action concrète de contrôle de son propre travail soit demandée, par exemple une liste de vérification que l’apprenant applique à sa production dans un exercice de tutorat.
Cette catégorie renvoie aux mécanismes d’autorégulation de l’apprentissage : planifier son activité, suivre sa progression et évaluer le résultat obtenu (Zimmerman, 2002).
5. Autre / indéterminé (Other/Unclear) : produire sans protocole pédagogique identifiable
Cette dernière catégorie regroupe principalement les prompts qui demandent la génération d’un artefact, par exemple une grille d’évaluation ou des supports de cours, sans protocole pédagogique identifiable.
La production d’un support destiné à l’enseignement n’est cependant pas classée automatiquement dans cette catégorie : si le prompt intègre une séquence pédagogique, un mécanisme d’investigation ou une autre fonction identifiable, cette fonction prévaut.

Comment cette taxonomie a-t-elle été testée ?
L’étude a été menée en deux étapes.
Un premier corpus de développement de 50 prompts en anglais a été constitué à partir de quatre bibliothèques publiques consultées le 9 février 2026 : More Useful Things (11 prompts), Wharton Interactive (6), Microsoft prompts-for-edu (6) et AI for Education (27). Les prompts ont été choisis pour couvrir l’éventail des catégories proposées par chaque bibliothèque.
Ce corpus reflétait une caractéristique des bibliothèques publiques actuelles : il était très majoritairement destiné aux enseignants (46 prompts sur 50).
Les deux auteurs de l’étude, chercheurs en technologies éducatives, ont codé indépendamment chaque prompt selon deux dimensions.
La première était sa fonction pédagogique dominante.
La seconde reposait sur la taxonomie SOLO (Structure of the Observed Learning Outcome), qui classe la complexité d’une réponse en niveaux successifs : uni-structurel, multi-structurel, relationnel et abstrait étendu (Biggs et Collis, 1982 ; Yaacoub et al., 2025). Elle était utilisée ici de manière exploratoire, pour vérifier si le niveau de complexité cognitive visé pouvait être inféré à partir du seul texte d’un prompt.
Pour mesurer la cohérence entre évaluateurs, l’étude utilise le pourcentage d’accord et le kappa de Cohen (κ). Ce dernier estime l’accord entre deux évaluateurs en tenant compte de la part d’accord qui pourrait apparaître par hasard. Selon l’échelle d’interprétation la plus courante, un κ compris entre 0,41 et 0,60 correspond à un accord modéré, entre 0,61 et 0,80 à un accord substantiel, et au-delà à un accord quasi parfait (Landis et Koch, 1977). Ces seuils restent conventionnels et varient selon les auteurs (McHugh, 2012).
Maîtrisez ChatGPT et les
IA Génératives
Démystifiez les outils d’IA générative et exploitez leur potentiel dans votre métier. Une approche 100 % pratique, sans prérequis technique.
Une première classification imparfaite, puis une nette progression après calibration
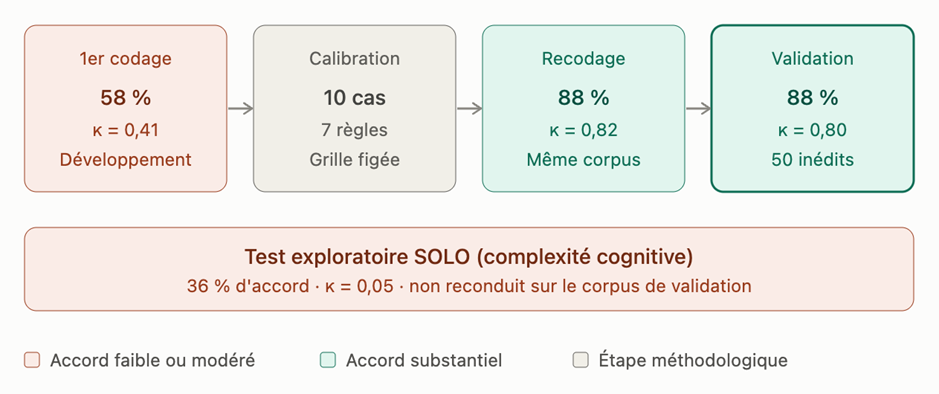
Lors du premier codage du corpus de développement, la classification selon la fonction pédagogique atteint 58 % d’accord, avec un κ de 0,41 (intervalle de confiance à 95 % : [0,24 ; 0,57]), soit un accord modéré.
Les désaccords se concentrent sur trois frontières : Étayage/Autre (4 cas), Étayage/Questionnement socratique (3) et Étayage/Métacognition (3).
Ce résultat est instructif en lui-même : des catégories ne deviennent pas fiables du seul fait qu’elles ont été définies ; leurs frontières doivent être assez précises pour que plusieurs évaluateurs les appliquent de manière cohérente.
Une session de calibration a donc porté sur dix cas présentant un fort désaccord. Elle a abouti à sept règles de décision, portant notamment sur la distinction entre questionnement socratique et étayage, et sur le traitement des prompts consacrés à la génération d’artefacts.
La grille de codage a ensuite été figée. Un nouveau codage du même corpus atteint alors 88 % d’accord et un κ de 0,82 ([0,67 ; 0,94]).
Cette progression, obtenue sur des prompts déjà discutés, ne suffisait cependant pas à démontrer que les règles fonctionnaient sur de nouveaux prompts.
La validation sur 50 prompts inédits
La taxonomie a donc été évaluée sur un second corpus de 50 prompts, constitué après la fixation de la grille de codage et excluant tout prompt du corpus de développement.
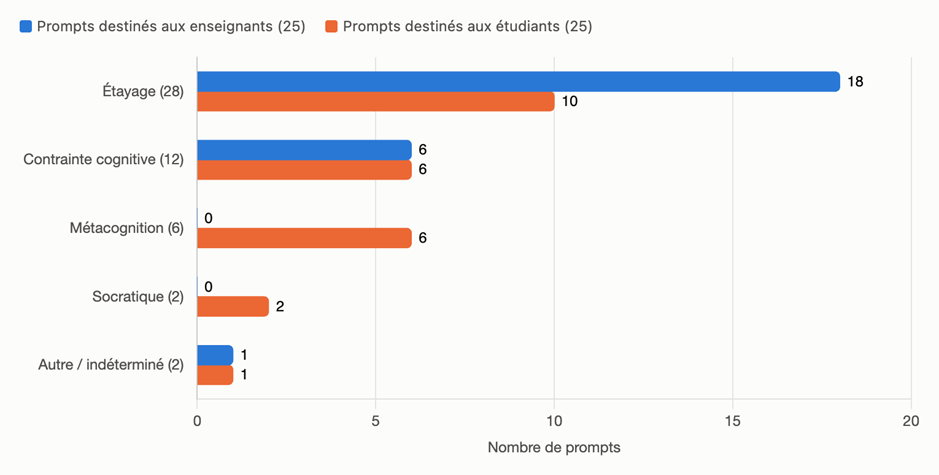
Ce corpus a été volontairement équilibré entre 25 prompts destinés aux enseignants et 25 prompts destinés aux étudiants, issus de Microsoft prompts-for-edu (6 et 8) et d’AI for Education (19 et 17).
Seule la fonction pédagogique y a été codée, en deux passages indépendants réalisés à l’aveugle avec la grille figée, sans discussion entre les passages avant le calcul de l’accord.
Le résultat principal est un accord de 88 %, avec κ = 0,80 et un intervalle de confiance à 95 % de [0,64 ; 0,93].
Les résultats sont proches pour les deux publics : 92 % d’accord et κ = 0,81 pour les prompts destinés aux enseignants, 84 % et κ = 0,78 pour ceux destinés aux étudiants.
Ces deux sous-échantillons ne comptent toutefois que 25 prompts chacun : ces chiffres restent indicatifs, et l’écart entre eux n’a pas fait l’objet d’un test statistique.
Dans les conditions de cette étude, ces résultats indiquent que la taxonomie conserve une fiabilité substantielle sur des prompts non utilisés pendant sa construction, qu’ils soient destinés aux enseignants ou aux étudiants. Toutes les frontières ne disparaissent pas pour autant. Les six désaccords résiduels portent sur Étayage/Contrainte cognitive (2), Étayage/Autre (2), Étayage/Questionnement socratique (1) et Étayage/Métacognition (1). Tous impliquent l’étayage, ce qui en fait, dans notre corpus, la catégorie dont les limites avec les autres fonctions restent les plus délicates à tracer.

Toutes les fonctions ne sont pas représentées de la même manière
Dans le corpus de validation, l’étayage est la fonction dominante, avec 28 prompts sur 50 : 18 destinés aux enseignants et 10 aux étudiants.
La contrainte cognitive représente 12 prompts, répartis à égalité entre les deux publics.
Les six prompts métacognitifs sont en revanche tous destinés aux étudiants, tout comme les deux prompts socratiques. La catégorie Autre / indéterminé comprend deux prompts.
Cette distribution doit être interprétée avec prudence. Le corpus a été construit volontairement à parts égales entre les deux publics, à partir de deux bibliothèques seulement : sa distribution décrit cet échantillon, et non la fréquence de ces fonctions dans l’ensemble des prompts éducatifs. Elle suggère néanmoins une hypothèse à tester sur des corpus plus larges : certaines fonctions, comme la métacognition et le questionnement socratique, pourraient être davantage présentes dans les prompts directement destinés aux apprenants.

Un résultat négatif instructif : les limites de SOLO à partir du prompt seul
L’un des résultats importants de l’étude ne concerne pas ce qui a fonctionné, mais ce qui n’a pas fonctionné de manière fiable.
Lors du premier codage, l’utilisation de SOLO pour inférer la complexité cognitive à partir du texte des prompts n’a produit que 36 % d’accord entre évaluateurs, avec κ = 0,05, soit un niveau proche du hasard.
Une pondération ordinale, qui tient compte de la distance entre les niveaux, n’a pas amélioré le résultat. Compte tenu de cette fragilité, le codage SOLO n’a pas été reconduit sur le corpus de validation.
L’écart avec la fonction pédagogique s’explique par la nature de ce qui est codé. Les fonctions de notre taxonomie correspondent souvent à des mécanismes explicitement formulés dans le texte : « procéder étape par étape », « utiliser une grille », « proposer un contre-argument », « vérifier son travail ».
La complexité cognitive suppose au contraire d’inférer le niveau de compréhension réellement demandé, une information que le prompt, pris isolément, fournit rarement.
Le même texte peut produire des interactions différentes selon le contexte, l’utilisateur, le modèle utilisé et les réponses successives générées au cours de l’échange.
Ce résultat invite à une prudence méthodologique : pour analyser la complexité cognitive avec une grille comme SOLO, l’unité d’analyse pertinente pourrait être le couple prompt-réponse, voire l’interaction complète, plutôt que le prompt seul.
Concevoir un prompt éducatif, c’est aussi décider où se situe l’effort cognitif
Cette taxonomie peut servir de grille de lecture, mais aussi d’outil de conception. Les recommandations qui suivent ne découlent pas des résultats de l’étude, qui n’observe pas d’apprentissages : elles découlent de son cadre théorique et rejoignent les recommandations existantes sur l’usage responsable de l’IA générative en éducation (Miao et Holmes, 2023 ; OCDE, 2026).
Elles invitent d’abord à éviter une logique systématique de « réponse d’abord », dans laquelle l’IA fournit immédiatement le résultat attendu.
L’étayage et le questionnement socratique peuvent au contraire préserver une part d’effort productif, en imposant des étapes intermédiaires ou des justifications.
La contrainte cognitive permet d’introduire explicitement des opérations de critique, de synthèse, de contre-argumentation ou d’évaluation.
Les prompts métacognitifs, enfin, peuvent rendre visibles les étapes de planification, de suivi et d’auto-évaluation.
Dans les modules et activités qui demandent l’écriture de code, j’observe souvent le même réflexe : l’étudiant colle son code et son message d’erreur, puis demande à l’IA de le corriger. Le prompt obtient une réponse, mais le diagnostic lui échappe. J’ai donc reformulé la consigne que je leur propose : l’assistant ne doit pas fournir de code corrigé, mais poser une question à la fois pour amener l’étudiant à formuler une hypothèse sur l’origine de l’erreur, puis à la vérifier. La tâche reste la même. Ce qui change, c’est la personne qui porte le raisonnement.
Aucune catégorie n’est pour autant intrinsèquement supérieure aux autres. La fonction pertinente dépend de l’objectif pédagogique, du contexte, de l’apprenant et de la manière dont l’interaction avec l’IA est réellement mise en œuvre.
Ces choix de conception ne sont pas seulement techniques. Décider de la part du raisonnement confiée à l’IA revient aussi à décider de l’autonomie laissée à l’apprenant : un prompt qui fournit systématiquement la réponse peut l’en dispenser, tandis qu’un prompt qui la retient lui en laisse la charge. Cette décision appelle de la transparence, car un étudiant qui ne comprend pas pourquoi l’assistant refuse de lui donner la solution peut percevoir cette retenue comme une limite de l’outil plutôt que comme un choix pédagogique. Elle soulève aussi une question d’inclusion : les prompts étudiés proviennent de bibliothèques anglophones conçues dans des contextes éducatifs particuliers, et leur transposition à des apprenants francophones ou multilingues ne va pas de soi. Enfin, ces prompts s’exécutent sur des modèles dont le comportement évolue au fil des versions ; une fonction pédagogique soigneusement inscrite dans un prompt dépend donc aussi de choix techniques qui échappent à l’enseignant.
Ce que cette étude permet d’affirmer, et ce qu’elle ne permet pas encore de conclure
L’étude montre qu’après calibration, les cinq fonctions proposées peuvent être distinguées avec une fiabilité substantielle sur le corpus de validation étudié.
Elle ne démontre pas, en revanche, qu’un type de prompt produit de meilleurs apprentissages qu’un autre.
L’analyse porte sur le texte des prompts : elle n’observe ni les interactions qui suivent, ni les réponses des modèles, ni le travail produit par les apprenants, ni leurs résultats d’apprentissage.
Or la fonction pédagogique inscrite dans un prompt peut évoluer lorsqu’elle est mise en œuvre dans une situation réelle.
Une prochaine étape de recherche consiste donc à relier les catégories de prompts aux interactions et aux résultats observés : par exemple, vérifier si les prompts d’étayage ou de questionnement socratique suscitent davantage d’effort productif (productive struggle), cet effort par lequel l’apprenant doit chercher, raisonner et justifier, que des prompts orientés vers la génération directe d’un résultat.
Plusieurs limites doivent aussi être prises en compte.
Les deux corpus sont de taille réduite et proviennent de bibliothèques publiques anglophones ; les résultats ne peuvent donc pas être généralisés sans précaution à des environnements multilingues, à des bibliothèques moins structurées ou à des situations réelles de tutorat.
Les corpus de développement et de validation proviennent en outre des mêmes grandes familles de sources. Enfin, la validation a été réalisée en deux passages indépendants avec la même grille figée, et non par une nouvelle équipe d’annotateurs. Elle doit donc être lue comme une stabilité hors échantillon de la grille de codage, plutôt que comme une démonstration complète de sa généralisation à d’autres équipes.
Du prompt comme instruction au prompt comme dispositif pédagogique
Le développement de l’IA générative en éducation pose une question qui dépasse la seule maîtrise du prompt engineering, c’est-à-dire de l’art de formuler des instructions efficaces pour un modèle.
Un prompt éducatif n’est pas uniquement une instruction destinée à obtenir une meilleure sortie : il détermine aussi qui raisonne, à quel moment, selon quelles contraintes et avec quel degré d’autonomie.
La taxonomie proposée fournit un vocabulaire pour analyser ces différences.
Elle ne constitue qu’une première étape. Il restera à observer comment ces fonctions se traduisent dans les interactions réelles et quels effets elles produisent sur les processus et les résultats d’apprentissage.
L’enjeu se déplace alors : il ne s’agit plus seulement d’écrire des prompts qui permettent à l’IA de mieux répondre, mais de concevoir des interactions dans lesquelles l’IA accompagne l’apprentissage sans absorber le travail cognitif qui en fait la valeur.
L’enjeu se déplace alors : il ne s’agit plus seulement d’écrire des prompts qui permettent à l’IA de mieux répondre, mais de concevoir des interactions dans lesquelles l’IA accompagne l’apprentissage sans absorber le travail cognitif qui en fait la valeur .
Références
[1] Biggs, J. B., et Collis, K. F. (1982). Evaluating the Quality of Learning: The SOLO Taxonomy (Structure of the Observed Learning Outcome). New York : Academic Press.
[2] Chen, E., et al. (2024). A Systematic Review on Prompt Engineering in LLMs for K-12 STEM Education. arXiv:2410.11123. Consulter la prépublication
[3] Landis, J. R., et Koch, G. G. (1977). The Measurement of Observer Agreement for Categorical Data. Biometrics, 33(1), 159-174.
[4] McHugh, M. L. (2012). Interrater Reliability: The Kappa Statistic. Biochemia Medica, 22(3), 276-282. Consulter l’article scientifique
[5] Miao, F., et Holmes, W. (2023). Guidance for Generative AI in Education and Research. Paris : UNESCO. Consulter le guide
[6] OCDE (2026). OECD Digital Education Outlook 2026. Paris : Éditions OCDE. Consulter le rapport
[7] Shi, Y., Yu, K., Dong, Y., et Chen, F. (2026). Large Language Models in Education: A Systematic Review. Computers and Education: Artificial Intelligence, 10, 100529. Consulter l’étude
[8] Wood, D., Bruner, J. S., et Ross, G. (1976). The Role of Tutoring in Problem Solving. Journal of Child Psychology and Psychiatry, 17(2), 89-100. Consulter l’article scientifique
[9] Yaacoub, A., et Assaghir, Z. (2027). From Engineering to Pedagogy: A Functional Taxonomy for Teacher and Student-Facing Educational Prompting. In J. Weidlich et al. (dir.), Mindful TEL: Learning Technologies Shaped with Intention. EC-TEL 2026. Lecture Notes in Computer Science, vol. 16906, p. 255-260. Cham : Springer. Consulter la publication
[10] Yaacoub, A., Assaghir, Z., et Da-Rugna, J. (2025). Cognitive Depth Enhancement in AI-Driven Educational Tools via SOLO Taxonomy. In ACR’25, LNNS 1346, p. 14-25. Springer. Consulter la publication
[11] Open Science Framework (OSF). Matériaux ouverts : corpus, grille de codage et classeur d’annotation. Consulter les matériaux de recherche